Computer Vision einfach erklärt: Definition, Nutzen und Beispiele
Inhaltsverzeichnis
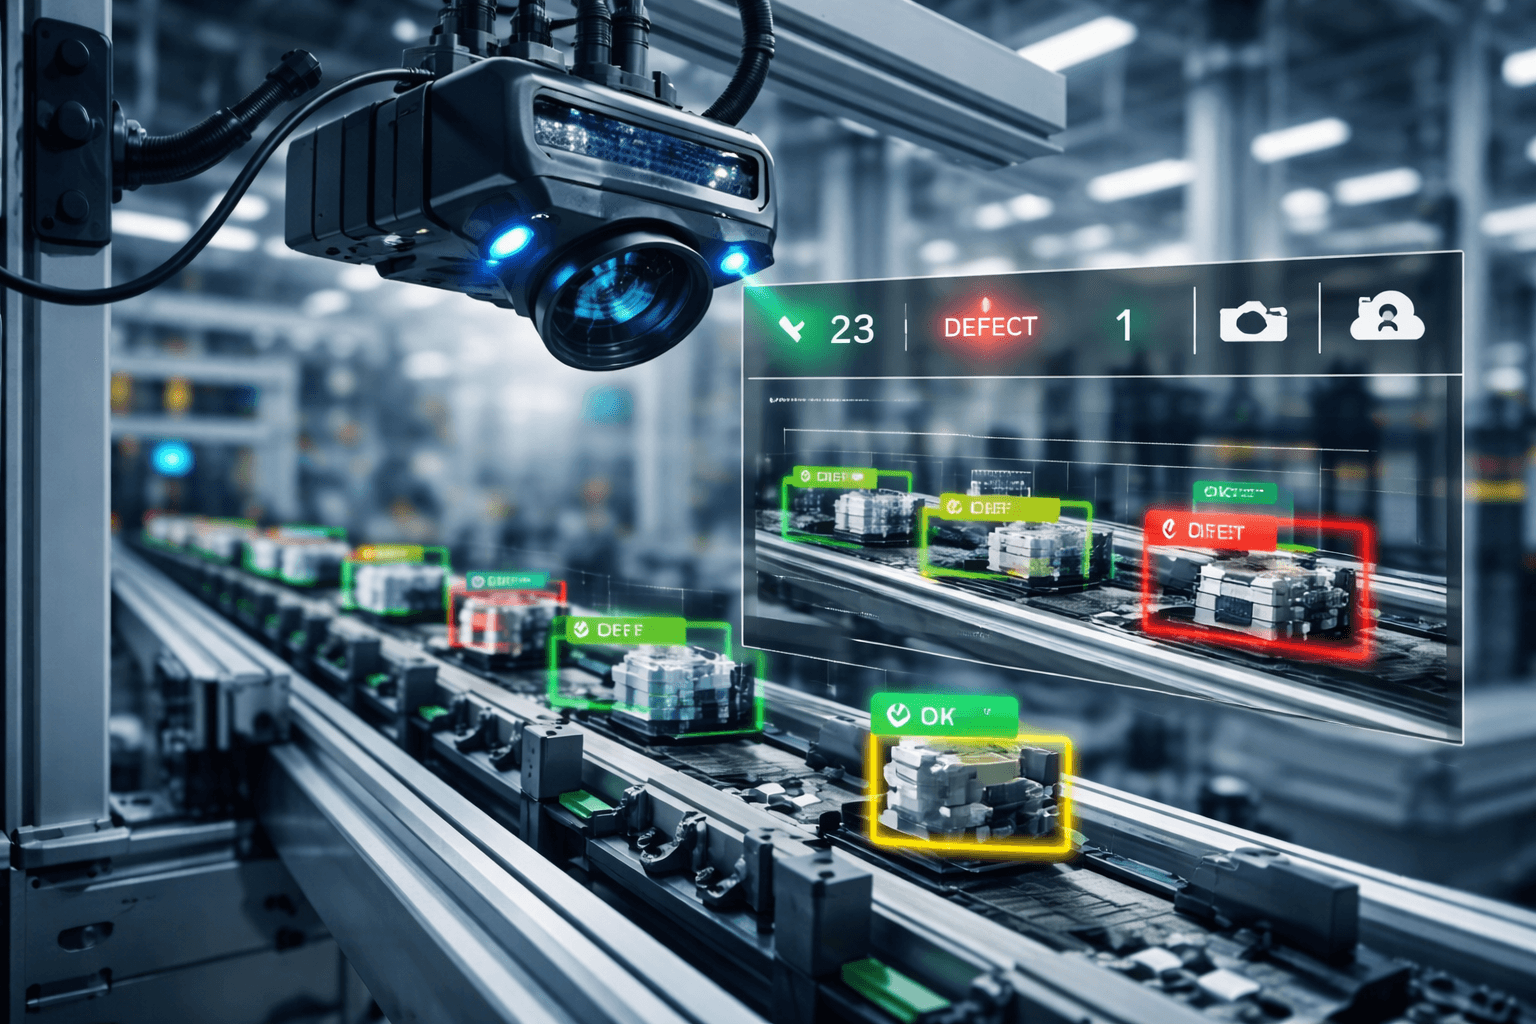
Computer Vision beschreibt die automatisierte Auswertung von Bildern und Videos, damit Maschinen visuelle Inhalte verstehen und daraus verlässliche Entscheidungen ableiten. Statt jedes Detail manuell zu prüfen, analysiert Computer Vision Millionen von Pixeln in Echtzeit, erkennt Objekte, Zustände, Anomalien oder Texte und wandelt sie in handfeste Informationen um.
Der geschäftliche Nutzen reicht von weniger Ausschuss und kürzeren Durchlaufzeiten bis zu höherer Prozesssicherheit und besserer Kundenexperience. Beispiele sind Oberflächenprüfung in der Fertigung, Zähl- und Wartezeitmessungen im Retail, Verkehrs- und Parkplatzanalysen in Smart Cities oder die automatische Erfassung von Dokumenten und Formularen.
Computer Vision lässt sich flexibel betreiben: on-premises für volle Kontrolle, in der Cloud für Skalierung oder am Edge für minimale Latenz und Datenschutz nahe an der Quelle. Entscheidend sind ein präziser Use-Case, saubere Daten, passende Algorithmen und eine robuste Integration, damit Computer Vision nicht nur Prototyp bleibt, sondern im Alltag echte, messbare Ergebnisse liefert.
Wie Computer Vision funktioniert: Von Pixeln zu Erkenntnissen
Am Anfang stehen Sensoren und Kameras, die Rohdaten liefern, gefolgt von einer Vorverarbeitung, welche Rauschen reduziert, Belichtung harmonisiert und die Geometrie korrigiert. Danach übersetzen Modelle die Pixel in Bedeutung: Klassifikation ordnet Kategorien zu, Detektion lokalisiert Objekte mit Bounding Boxes, Segmentierung trennt Klassen auf Pixelebene, und Tracking verbindet Ereignisse über die Zeit.
Post-Processing mit Regeln, Kalibrierungen oder Businesslogik verfeinert die Ergebnisse und leitet sie an ERP, MES oder Alarmierungs-Workflows weiter. Training und Inferenz sind klar getrennt: Ein Modell lernt aus annotierten Beispielen und wird anschließend für neue Daten eingesetzt.
Für belastbare Computer Vision Lösungen zählen außerdem Edge- oder Cloud-Architektur, Bandbreite, Latenz, Ausfallsicherheit und Observability. Ergänzend sorgen MLOps, Reproduzierbarkeit, Versionierung und Drift-Monitoring dafür, dass Computer Vision nicht erodiert, sondern sich mit veränderten Bedingungen weiterentwickelt und dauerhaft konsistente Qualität liefert.
Wichtige Bausteine: Bildverarbeitung, Feature-Extraktion, Deep Learning
Bildverarbeitung ist das Fundament vieler Computer Vision Pipelines. Kontrastanpassung, Filter, Kantendetektion, Morphologie, Farbmodelle und geometrische Transformationen stabilisieren Eingaben und machen Muster sichtbar.
Darauf aufbauend extrahieren klassische Verfahren wie SIFT, SURF oder HOG robuste Merkmale, die selbst bei leicht veränderten Perspektiven funktionieren. Mit Deep Learning werden Features automatisch gelernt: Convolutional Neural Networks kombinieren lokale Filter zu hierarchischen Repräsentationen, die komplexe Strukturen erfassen.
Häufig überzeugt eine hybride Strategie, bei der Bildverarbeitung das Signal verbessert, während Deep Learning die semantische Interpretation übernimmt. Ergänzt wird dies durch optischen Fluss, Keypoint- und Landmark-Erkennung, Stereo- oder Tiefeninformationen.
Für produktive Computer Vision Anwendungen spielen außerdem Kamera- und Beleuchtungssetup, Kalibrierung, Datenaugmentation und saubere Evaluation eine zentrale Rolle. So entsteht eine Pipeline, die nicht nur im Labor beeindruckt, sondern in der Realität zuverlässig abliefert, wenn Computer Vision täglich Entscheidungen unterstützen soll.
Zentrale Algorithmen und Modelle in der Computer Vision
Die Wahl der Architektur hängt vom Ziel ab. Für Klassifikation zählen ResNet, EfficientNet und ConvNeXt zu den Standards, während Objekterkennung oft mit YOLOv5–v8, Faster R-CNN oder RetinaNet umgesetzt wird.
Für semantische und instance-bezogene Segmentierung dominieren U-Net, DeepLab und Mask R-CNN. OCR-Workflows kombinieren Detektoren für Textregionen mit Sequenzmodellen wie CRNN oder Transformer-Decodern.
Keypoint-Modelle wie HRNet und MediaPipe liefern präzise Landmark-Positionen, Tracking wird mit SORT, DeepSORT oder ByteTrack skaliert. In der Anomalieerkennung bewähren sich Autoencoder, Feature-Distanz-basierte Verfahren wie PatchCore oder differenzielle Statistiken.
Klassische Methoden – Canny, Hough, Otsu – bleiben relevant, wenn das Umfeld kontrolliert ist und deterministische Stabilität gefragt ist. In der Praxis werden Computer Vision Modelle mit Confidence-Kalibrierung, Test-Time-Augmentation, Ensembles und Post-Processing veredelt.
So entsteht ein System, das Fehlalarme senkt und auch bei wechselndem Licht, neuen Hintergründen oder seltenen Fällen belastbar bleibt.
CNNs, Transfer Learning und Vision Transformers (ViT) im Überblick
CNNs sind seit Jahren das Rückgrat von Computer Vision, weil sie lokale Muster effizient extrahieren und mit wachsender Tiefe globale Zusammenhänge verstehen.
Transfer Learning reduziert Datenbedarf und Trainingszeit: Vortrainierte Gewichte auf Bilddatenbanken wie ImageNet werden für den eigenen Use-Case feinjustiert und liefern oft mit wenigen tausend Bildern solide Resultate.
Vision Transformers nutzen Selbstaufmerksamkeit, um Beziehungen zwischen Bildpatches direkt zu modellieren, skalieren hervorragend und überzeugen insbesondere bei großen Datasets oder Multi-Task-Szenarien.
Hybride Varianten wie Swin Transformer oder ConvNeXt verbinden die Stärken beider Welten. Für edge-nahe Computer Vision Einsätze sind effiziente Architekturen entscheidend: MobileNet, ShuffleNet, EfficientNet-Lite oder quantisierte und geprunte Modelle bringen Realtime bei begrenzter Leistung.
Neben Top-1-Accuracy oder mAP zählen Modellgröße, Latenz, Energiebedarf und Robustheit gegen Domain-Shift – denn in produktiven Computer Vision Projekten entscheidet die Gesamtperformance, nicht nur die Benchmarks im Labor.
Praxisanwendungen: So setzt Du Computer Vision sinnvoll ein
Erfolgreiche Projekte starten mit einer klaren Problemdefinition, einer belastbaren Baseline und messbaren Zielen, die direkt an Geschäftskennzahlen andocken.
Prüfe früh, ob Edge, On-Prem oder Cloud das richtige Betriebsszenario für Deine Computer Vision Pipeline darstellt, und berücksichtige Datenschutz, Latenz, Bandbreite und Wartungsaufwand.
Plane Ende-zu-Ende: Datenzufluss, Vorverarbeitung, Modell, Post-Processing, API, UI und Integration in bestehende Systeme. Statt Big-Bang hilft ein Pilot an repräsentativen Standorten, Hypothesen zu testen, Engpässe zu identifizieren und Stakeholder zu überzeugen.
Schulungen, klare SOPs und ein MLOps-Setup sorgen dafür, dass Computer Vision nicht als Inselprojekt endet, sondern Prozesse dauerhaft verbessert. Denke an Betriebsdetails: Kamerareinigung, Kalibrierzyklen, Firmware-Updates, Monitoring und Fallback-Regeln bei Netzwerkausfällen.
So entsteht aus einem gut definierten Use-Case ein skalierbares Produktivsystem, in dem Computer Vision zuverlässig Ergebnisse liefert und kontinuierlich aus realem Feedback besser wird.
Qualitätssicherung, Sicherheit, Retail, Medizin und Industrie 4.0
In der Qualitätssicherung erkennt Computer Vision Kratzer, Grate, Deformationen oder Montagemängel konsistent und dokumentiert Ergebnisse rückverfolgbar.
Sicherheitsanwendungen profitieren von Zutrittskontroll-Workflows, Gefahrenzonenerkennung oder Perimeterschutz – kombiniert mit Anonymisierung und DSGVO-konformem Betrieb.
Im Retail unterstützt Computer Vision Bestands- und Planogramm-Compliance, Self-Checkout, Front-Facing-Kontrollen und Heatmaps zur Flächenoptimierung.
In der Medizin dienen Algorithmen als Assistenz bei Bildbefunden in Radiologie, Dermatologie oder Pathologie, stets mit Human-in-the-Loop und transparenten Abläufen.
Industrie 4.0 verknüpft Robotik, Sensorik und Computer Vision für präzises Pick-and-Place, autonome Prüfstationen, Cobots oder vorausschauende Wartung.
Übergreifend zählen robuste Hardware-Setups, durchdachte Beleuchtung, realistische Testszenarien, klare KPIs und die enge Zusammenarbeit zwischen Fachbereichen, IT und Compliance. Damit zahlt Computer Vision unmittelbar auf Qualität, Sicherheit, Produktivität und Kundenerlebnis ein – und zwar messbar entlang belastbarer Kennzahlen.
Datenstrategie: Datasets, Annotation und Data Augmentation
Ohne verlässliche Datenbasis wird Computer Vision zum Glücksspiel. Sorge für Datenerhebung, die echte Varianz abbildet: verschiedene Anlagen, Blickwinkel, Hintergründe, Schichten, Jahreszeiten und Lieferchargen. Ein detailliertes Labeling-Handbuch mit Ontologien, Beispielbildern und Qualitätsregeln (Inter-Annotator-Agreement) verhindert Inkonsistenzen.
Nutze Toolchains mit Review-Workflows, aktives Lernen für harte Fälle und Semi-Supervised-Ansätze, um Labelaufwand zu reduzieren. Data Augmentation – von Crop und Flip über Farb-Jitter bis zu MixUp/CutMix – erhöht Robustheit gegen Rauschen, Kompression, Bewegungsunschärfe und Perspektivwechsel.
Für seltene Klassen helfen synthetische Daten, Domain Randomization und Simulation. Versionsmanagement für Datasets, klare Train/Val/Test-Splits und lückenlose Dokumentation bewahren Dich vor Datenleckagen.
In produktiven Computer Vision Setups ist ein geschlossener Datenkreislauf zentral. Sampling neuer Szenen am Edge, Priorisierung von Fehlklassen, Retraining und regelmäßige Re-Evaluierung. So bleibt Computer Vision eng an der Realität und verbessert sich dort, wo Fehler tatsächlich Kosten verursachen.
Metriken und Evaluation: So misst und verbesserst Du die Performance
Gute Metriken sind das Steuerpult für Computer Vision. Für Klassifikation zählen Accuracy, Precision, Recall, F1 und AUROC; Detektion bewertet man mit AP/mAP über verschiedene IoU-Schwellen, Segmentierung mit IoU oder Dice pro Klasse.
Zusätzlich wichtig: Latenz (P95/P99), Durchsatz (FPS), Speicherbedarf und Energieverbrauch – besonders für Edge-Szenarien.
Analysiere Ergebnisse pro Kamera, Standort, Schicht oder Materialtyp, um blinde Flecken zu entdecken. Robustheit steigt mit sauberen Splits, Cross-Validation und einem echten Holdout-Set.
Fehleranalysen zeigen, ob Klassen verwechselt werden, Hintergründe dominieren oder Beleuchtung stört. Confidence-Kalibrierung verbessert Entscheidungsqualität downstream.
Im Betrieb brauchen Computer Vision Systeme Drift-Monitoring, Alerting bei Metrikeinbrüchen, Canary-Releases und A/B-Tests. Berücksichtige Businesskosten: False Positives und False Negatives wirken unterschiedlich.
Optimiere gezielt dort, wo Fehlentscheidungen am teuersten sind – dann liefert Computer Vision die größte Hebelwirkung bei vertretbaren Betriebskosten.
Tools & Tech-Stack: OpenCV, PyTorch, TensorFlow, ONNX, Edge-Deployments
OpenCV ist das vielseitige Werkzeug für I/O, Bildverarbeitung und schnelle Prototypen in Computer Vision Projekten. PyTorch und TensorFlow/Keras dominieren das Training tiefer Modelle; Ecosysteme wie Albumentations, Lightning, Optuna, Weights & Biases oder MLflow beschleunigen Entwicklung, Tuning und Nachvollziehbarkeit.
Für Portabilität sorgen ONNX und ONNX Runtime; Beschleuniger nutzen TensorRT (NVIDIA), OpenVINO (Intel), Core ML (Apple) oder TFLite (Mobil/Edge).
Stabiler Betrieb entsteht mit FastAPI/gRPC für Serving, GStreamer/RTSP für Video, Docker/Kubernetes für Orchestrierung und Observability via Prometheus/Grafana.
Edge-Deployments profitieren von Jetson, Intel iGPU, Coral TPU oder ARM-SoCs und setzen auf Quantisierung, Pruning und Compiler wie TVM.
In produktiver Computer Vision Praxis sichern IaC (Terraform, Ansible), Secret-Management, PKI und Remote-Updates reproduzierbare, sichere Releases. Standardisierte Schnittstellen und Telemetrie verkürzen Debugging-Zeiten – so bleibt Computer Vision vom Labor bis zur Werkshalle beherrschbar.
Herausforderungen, Bias, Datenschutz & Ethik: Was Du beachten solltest
Computer Vision greift tief in Prozesse ein, daher sind Fairness, Sicherheit und Datenschutz Pflichtbestandteile – nicht Kür. Prüfe Rechtsgrundlagen, Zweckbindung, Speicherfristen und Löschkonzepte gemäß DSGVO, dokumentiere Prozesse transparent und minimiere Datenverarbeitung nach dem Prinzip Privacy by Design.
On-Device-Inferenz, Edge-Verarbeitung, Pseudonymisierung oder Anonymisierung reduzieren Risiken. Technischer Bias sinkt mit diversen Datensätzen, ausgewogenen Klassen und regelmäßigen Audits; ergänzend helfen Model Cards, die Annahmen, Grenzen und Failure Modes festhalten.
Kritische Use-Cases erhalten Human-in-the-Loop, Safeguards und klare Rollback-Optionen. Für die Sicherheit produktiver Computer Vision Systeme zählen Netzwerksegmentierung, Härtung von Endpunkten, signierte Modelle, Secret-Management und ein Patch- und Vulnerability-Programm.
Incident-Response mit definierten Eskalationen sowie Schulungen stärken Resilienz. Offene Kommunikation mit Stakeholdern schafft Vertrauen – die Grundlage, damit Computer Vision langfristig akzeptiert, wirksam und rechtskonform betrieben werden kann.
Ausblick: Trends – Multimodalität, Edge AI und Generative Vision
Multimodale Ansätze verknüpfen Bild, Text, Audio und Sensordaten, wodurch Computer Vision flexibler auf neue Aufgaben reagiert. Foundation-Modelle mit universellen Bild-Embeddings ermöglichen Zero-Shot- oder Few-Shot-Szenarien, Open-Vocabulary-Detektion und besseres Vision-Language-Reasoning.
Edge AI profitiert von sparsamen Transformern, effizienteren CNNs, Quantisierung und Compilern wie TVM – Realtime bei geringem Energiebedarf wird auch auf kleinen Geräten erreichbar. Generative Verfahren wie Diffusion, NeRFs oder 3D Gaussian Splatting erzeugen synthetische Daten, simulieren Grenzfälle und schaffen digitale Zwillinge für Tests ohne Produktionsrisiko.
Gleichzeitig steigen Anforderungen an Steuerbarkeit, Lizenz-Compliance und Sicherheit. Die Gewinner strukturieren Datenflüsse, standardisieren MLOps und etablieren ein kontinuierliches Lernsystem. So kann Computer Vision domänenübergreifend generalisieren, erklärbar bleiben und sich mit wenig Aufwand an neue Kontexte anpassen – ein klares Plus, wenn Produktzyklen kürzer werden und Innovationsdruck zunimmt.
So startest Du: Projekt-Checkliste, Ressourcen und Quick-Wins
Setze den Rahmen mit einem präzisen Ziel, realistischen KPIs und einem klaren Scope.
Prüfe Kameras, Optik, Licht, Blickwinkel und Netzwerk, bevor Du Modelle auswählst – eine starke Basis zahlt sich in jeder Computer Vision Phase aus.
Starte mit einem Pilot, der repräsentative Varianz enthält, und nutze Transfer Learning, um schnell eine solide Baseline zu erreichen.
Wähle Edge, On-Prem oder Cloud je nach Latenzanforderung, Datenschutz und Betriebskosten.
Etabliere früh MLOps: Daten- und Modellversionierung, reproduzierbares Training, automatisierte Evaluation, Monitoring und Canary-Releases.
Quick-Wins liefern OCR-Workflows, einfache Anomalieerkennung, Zählaufgaben oder visuelle Prüfungen an fixen Stationen.
Sammle Fehlfälle systematisch, priorisiere das Nachlabeln, retraini regelmäßig und dokumentiere Änderungen.
So wächst aus einem pragmatischen Start ein professionelles Computer Vision System, das transparent arbeitet, skaliert und zuverlässig in bestehende Prozesse integriert ist – mit messbarem Nutzen vom ersten Meilenstein an.
Häufige Fragen
Wie viele Daten werden benötigt? ⌄
Mit Transfer Learning reichen oft einige hundert bis tausend gelabelte Beispiele; komplexe Computer Vision Aufgaben profitieren von zehntausenden Bildern und sinnvoller Augmentation.
Welche Hardware ist sinnvoll? ⌄
Für Realtime-Detektion helfen GPUs oder Edge-Beschleuniger, für Batch-Jobs reichen optimierte CPUs.
Wie messe ich Erfolg? ⌄
Für Detektion mAP bei verschiedenen IoU-Schwellen, für Segmentierung IoU/Dice, für Klassifikation F1/Accuracy, ergänzt um Latenz, FPS und Fehlalarme im Betrieb.
Was kostet es? ⌄
Kosten ergeben sich aus Datenerhebung, Annotation, Training, Deployment und Betrieb; ein fokussierter MVP mit Computer Vision kann schlank starten und später skaliert werden.
Wie reduziere ich Fehlalarme? ⌄
Durch bessere Daten, gezielte Augmentation, Kalibrierung, Post-Processing und Retraining mit Fehlfällen.
Ist Datenschutz machbar? ⌄
Ja, mit Edge-Inferenz, Pseudonymisierung, strengen Zugriffsrechten und klaren Richtlinien.
Wie komme ich schnell los? ⌄
Mit enger Zieldefinition, einem repräsentativen Pilot und vortrainierten Computer Vision Modellen, flankiert von einem leichten, aber sauberen MLOps-Setup.
Über Carl Reed
Ich bin Carl, Euer digitaler Sherpa auf der Reise durch die unendlichen Weiten von Hardware, Software, E-Commerce und allem, was das Internet zu bieten hat. In einer Welt, die sich schneller dreht, als eine SSD lädt, bin ich hier, um euch dabei zu helfen, auf dem neuesten Stand zu bleiben und die unglaublichen Möglichkeiten zu nutzen, die diese Technologien uns bieten.